引言:参数竞赛漏掉了另一半
如果把 2020—2021 年的大模型竞赛压缩成一句话,大概是:显卡更多,就把模型做得更大。 GPT-3 有 175B 参数,Gopher 有 280B,Megatron-Turing NLG 更冲到 530B。参数量成了最醒目的进度条,训练数据却常停留在约 300B token 的量级。
这背后并不是盲目崇拜“大”。Kaplan 等人在 2020 年得到的缩放律指出,大模型的样本效率更高;在固定计算预算下,似乎应该优先增加参数,并在模型还没有充分收敛时停止训练。问题是,当实验跨到更大的模型和更长的训练区间,这个结论还成立吗?
2022 年,DeepMind 的 Training Compute-Optimal Large Language Models 给出了一个几乎反直觉的答案:当训练计算量固定时,当时的主流模型普遍参数太多、数据太少。与其造一个巨大的“半成品”,不如用更小的模型读更多数据。
封面:同等训练能量下,参数规模与数据量必须共同分配
论文训练了 400 多个模型,规模从 70M 到 16B 以上,训练数据从 5B 到 500B token。然后它做了最有说服力的实验:用与 Gopher 基本相同的训练 FLOPs,训练一个只有 70B 参数、却看过 1.4T token 的模型——Chinchilla。结果,这个小四倍的模型几乎全面胜过 280B 的 Gopher。
Chinchilla 的意义因此不只是一个新模型,而是把问题从“模型还能做多大”改写为:给定一笔算力,参数和数据应该怎样分账?
先把账算清:训练计算量由什么决定
对标准稠密 Transformer,一次训练的主导计算量可以近似写成:
$$C \approx 6ND$$其中 $C$ 是训练 FLOPs,$N$ 是非 embedding 参数量,$D$ 是训练 token 数。常数 6 来自前向与反向传播的近似成本;精确工程核算会受到注意力长度、激活重算等因素影响,但这个式子足够描述缩放关系。
固定 $C$ 后,$N$ 与 $D$ 形成跷跷板:参数翻倍,能看的 token 就必须减半。真正的目标并不是让任一项最大,而是让最终验证损失最小。
论文用一个可分解的经验损失函数表达两种瓶颈:
$$L(N,D)=E+\frac{A}{N^\alpha}+\frac{B}{D^\beta}$$- $E$ 是数据分布本身难以消除的熵下限;
- $A/N^\alpha$ 表示模型容量不足造成的损失;
- $B/D^\beta$ 表示数据不足、训练不充分造成的损失。
参数很多但数据太少时,第二项不会因为模型变大而自动消失。这正是“欠训练”一词在 Chinchilla 语境中的含义:不是优化器没跑完,而是相对于模型容量,token 预算不够。
三条证据如何指向同一个结论
Chinchilla 论文没有只拟合一条曲线。它用三种方法交叉验证计算最优前沿。
第一种方法固定模型大小,改变训练 token 数,观察每条训练曲线在不同计算预算下能达到的最低损失,再拟合最优 $N$ 和 $D$ 随 $C$ 的变化。得到的指数约为:
$$N_{opt}\propto C^{0.50},\qquad D_{opt}\propto C^{0.50}$$第二种方法构造 IsoFLOP 曲线:对每个固定 FLOP 预算,训练多种参数量与 token 数组合。把最终损失画成参数量的函数,会看到一个清晰的“谷底”。谷底位置随算力移动,拟合指数约为 0.49 和 0.51。
第三种方法直接对全部实验点拟合前面的参数化损失函数,得到的指数约为 0.46 和 0.54。三种方法的数值并不完全相同,却给出相同方向:算力增加时,参数量与训练数据量应大致等比例增长。
这修正了早期 Kaplan 缩放律中“更多预算主要拿去增大模型”的配置。工程上常把 Chinchilla 结果简化为“每个参数约 20 个 token”:70B × 20 ≈ 1.4T。这个比例很有用,但它不是自然常数。它依赖数据分布、模型族、训练目标和拟合区间;真正稳健的结论是参数与数据要共同扩展,而不是永远机械套用 20:1。
同样算力:70B 为什么能赢 280B
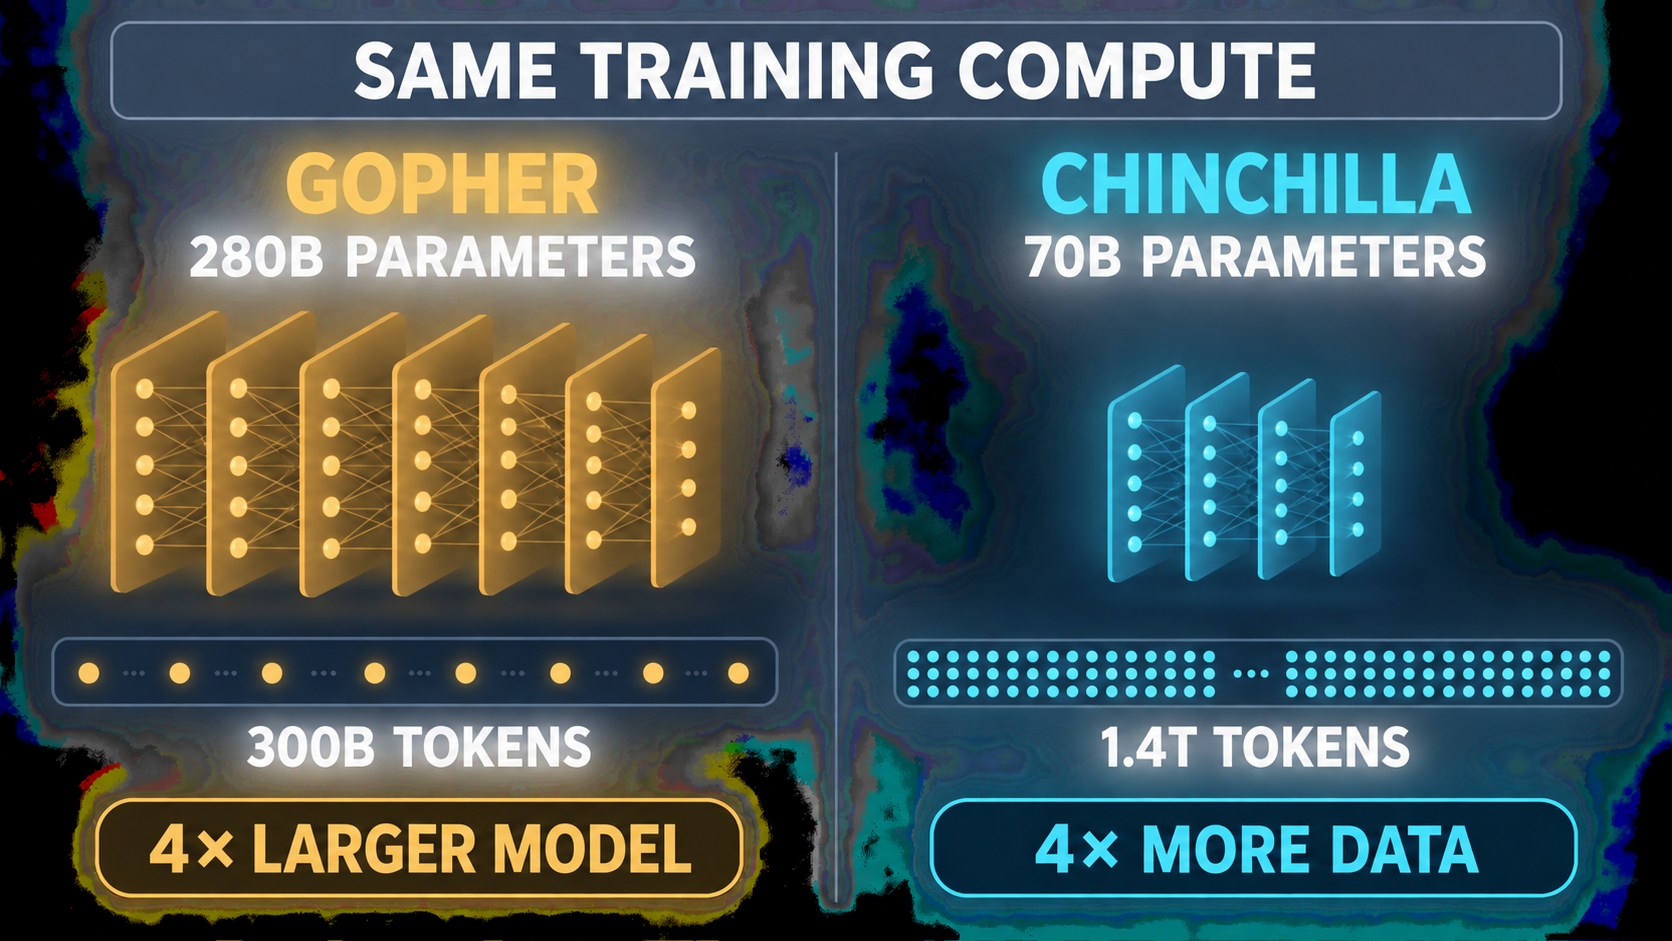
图 1:Gopher 与 Chinchilla 使用近似相同的训练算力;Chinchilla 把预算从参数量转向更多训练 token
Gopher 有 280B 参数,训练约 300B token;Chinchilla 有 70B 参数,训练 1.4T token。粗略看,模型缩小四倍,数据增加约四倍,两者的 $N\times D$ 因而处在相近量级。
这不是通过更换一种革命性架构取胜。论文明确说明 Chinchilla 基本沿用 Gopher 的模型架构和训练设置,主要差异包括数据配比、AdamW 优化器以及略作修改的 SentencePiece tokenizer。换句话说,胜负的核心证据来自计算预算分配,而不是架构魔法。
结果非常直接:
| 指标 | Gopher 280B | Chinchilla 70B | 含义 |
|---|---|---|---|
| 训练 token | 约 300B | 1.4T | 更充分地消化模型容量 |
| MMLU 5-shot | 约 60.0% | 67.6% | 平均提升 7.6 个百分点 |
| LAMBADA | 74.5% | 77.4% | 更小模型仍有更强阅读预测 |
| BIG-bench 平均 | 54.4% | 65.1% | 62 项中仅 4 项落后 |
在 MMLU 的 57 个任务中,Chinchilla 有 51 个优于 Gopher,2 个持平,只有 4 个更差。论文还显示它在大量任务上胜过 GPT-3、Jurassic-1 与 530B 的 MT-NLG。这里最值得记住的不是某个 benchmark 的小数点,而是反事实:如果同样的算力被错误地堆成更大参数量,最后得到的模型反而更差。
训练最优,不等于产品最优
Chinchilla 的目标函数只问一件事:固定预训练 FLOPs,怎样把训练损失降到最低。但真实产品还有部署成本。
70B 模型不仅训练效果更好,推理时也比 280B 模型需要更少内存、更低带宽和更少计算。因此,Chinchilla 在这个案例里同时改善了训练结果与服务成本。不过从更一般的角度看,“训练一次”与“调用十亿次”并不是同一本账。
2024 年的 Beyond Chinchilla-Optimal 把预期推理需求纳入优化,结论是:当服务调用量很大时,可能值得把模型做得比 Chinchilla 最优点更小,再用更多 token 训练。预训练多花一次钱,换来每次推理都更便宜。这也解释了后来模型的“过度训练”趋势。
Meta 的 Llama 3 是很好的官方例子。Meta 表示,按 Chinchilla 基准,8B 模型的计算最优训练量约为 200B token,但其 8B 和 70B 模型训练到 15T token 时仍持续改善。这里没有推翻 Chinchilla:目标已经从“给定训练 FLOPs 的最低损失”变成“兼顾质量与长期推理效率的产品模型”。
所以更完整的决策链应当是:
- 先用缩放实验估计参数、数据与损失的关系;
- 再把可用数据质量、训练硬件与时间窗口纳入约束;
- 最后加入模型生命周期内的推理量、延迟和显存成本。
“20 token/参数”是起点,不是采购清单。
数据成为新的稀缺资源
旧范式的主要瓶颈是如何把更大的模型切到更多加速器上;Chinchilla 之后,数据工程被推到同等重要的位置。论文估算,一个 175B 参数模型若位于其计算最优前沿,需要数万亿 token,而不是 GPT-3 使用的约 300B token。再往上扩展,所需的高质量、去重、合规数据增长得极快。
“更多 token”也不能简单等同于“重复抓更多网页”。低质量数据会改变损失函数的常数和指数,重复数据还可能让模型记忆而非泛化。数据清洗、去重、语言与领域配比、污染检测,都会决定额外 token 是否真的提供新信息。
我认为 Chinchilla 最深的产业影响,是把数据从训练流水线的原料变成了模型设计变量。架构团队不能先拍板参数量,再让数据团队“尽量填满”;两者必须在同一个预算模型里联合设计。
护栏视角
缩放律看起来是一项效率研究,但它也直接影响安全边界。
第一,计算最优不代表风险最优。更多高质量 token 会提高知识覆盖与泛化能力,也可能提高模型在网络攻击、欺骗或敏感领域的能力。能力评估与危险能力评估必须跟着预训练规模同时扩展,不能等训练完成后才补测。
第二,数据量压力会诱发来源与隐私风险。当路线图要求数万亿 token,团队更容易降低授权、个人信息清理和数据溯源标准。一个“计算上最优”的语料方案,可能在版权、隐私与偏见上完全不可接受。数据治理应当是预算约束,而不是训练后的合规附件。
第三,缩放律是外推工具,不是安全证明。论文的拟合来自特定模型族、数据混合和计算区间;把曲线外推数个数量级,本身就带有不确定性。上线决策仍需要实测、红队、分层访问和持续监控,不能因为损失曲线可预测,就假设行为也同样可预测。
我的判断是:Chinchilla 教会行业“不要浪费训练算力”,安全团队则需要补上下一句——也不要为了吃满缩放律而浪费数据治理与评估余量。 最优点必须同时对技术、成本和风险负责。
总结
Chinchilla 用一个极其干净的对照实验终结了单看参数量的竞赛叙事:70B 参数、1.4T token,在与 280B Gopher近似相同的训练计算量下取得更好结果。
它留下了三条至今仍有价值的原则:
- 固定训练预算时,参数量和数据量必须联合优化;
- 参数与 token 大致等比例扩展,比只堆参数更接近计算最优;
- 训练最优只是一个目标,数据质量与生命周期推理成本会把实际产品推向更小、训练更久的模型。
参数量告诉我们模型能装下多少容量,token 数决定这些容量是否真正被训练出来。大模型的“规模”从此不再是一个数字,而是参数、数据、算力与部署需求共同组成的系统。
参考资料
- Hoffmann, J. et al. Training Compute-Optimal Large Language Models. NeurIPS 2022. https://arxiv.org/abs/2203.15556
- Google DeepMind. An empirical analysis of compute-optimal large language model training. https://deepmind.google/blog/an-empirical-analysis-of-compute-optimal-large-language-model-training/
- Kaplan, J. et al. Scaling Laws for Neural Language Models. 2020. https://arxiv.org/abs/2001.08361
- OpenAI. Scaling laws for neural language models. https://openai.com/index/scaling-laws-for-neural-language-models/
- Sardana, N. et al. Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws. ICML 2024. https://proceedings.mlr.press/v235/sardana24a.html
- Meta AI. Introducing Meta Llama 3. https://ai.meta.com/blog/meta-llama-3/