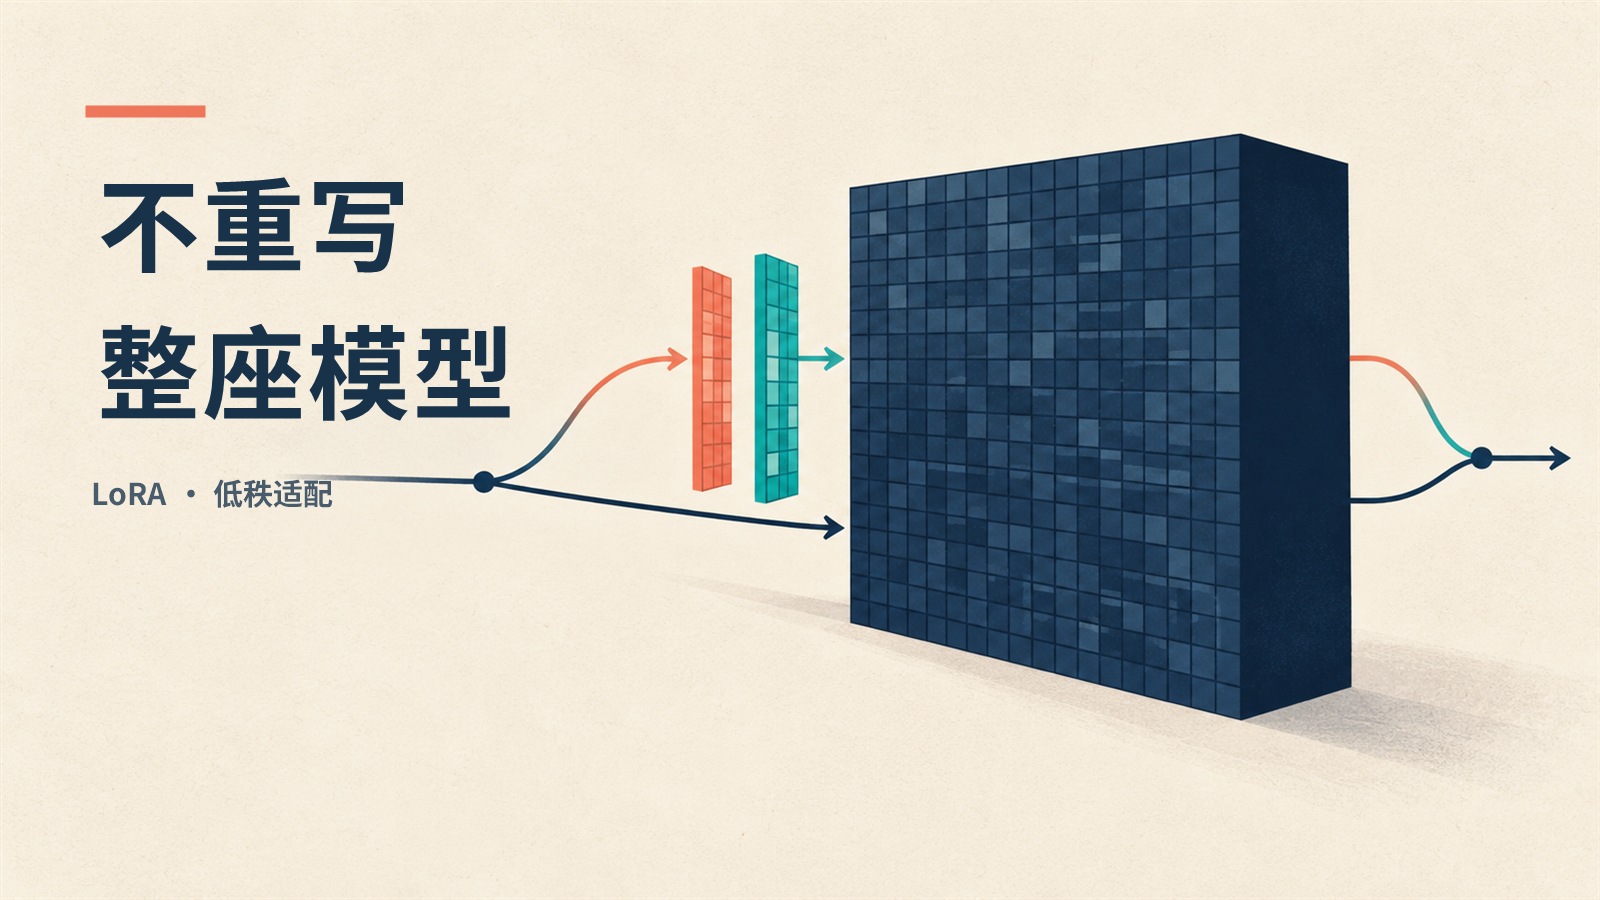
LoRA:不重写整座模型,如何学会一项新任务
LoRA 冻结预训练权重,只学习一个低秩更新。本文从矩阵分解、训练账本与 QLoRA 出发,解释它为什么便宜、何时可以合并,以及低秩假设的边界。
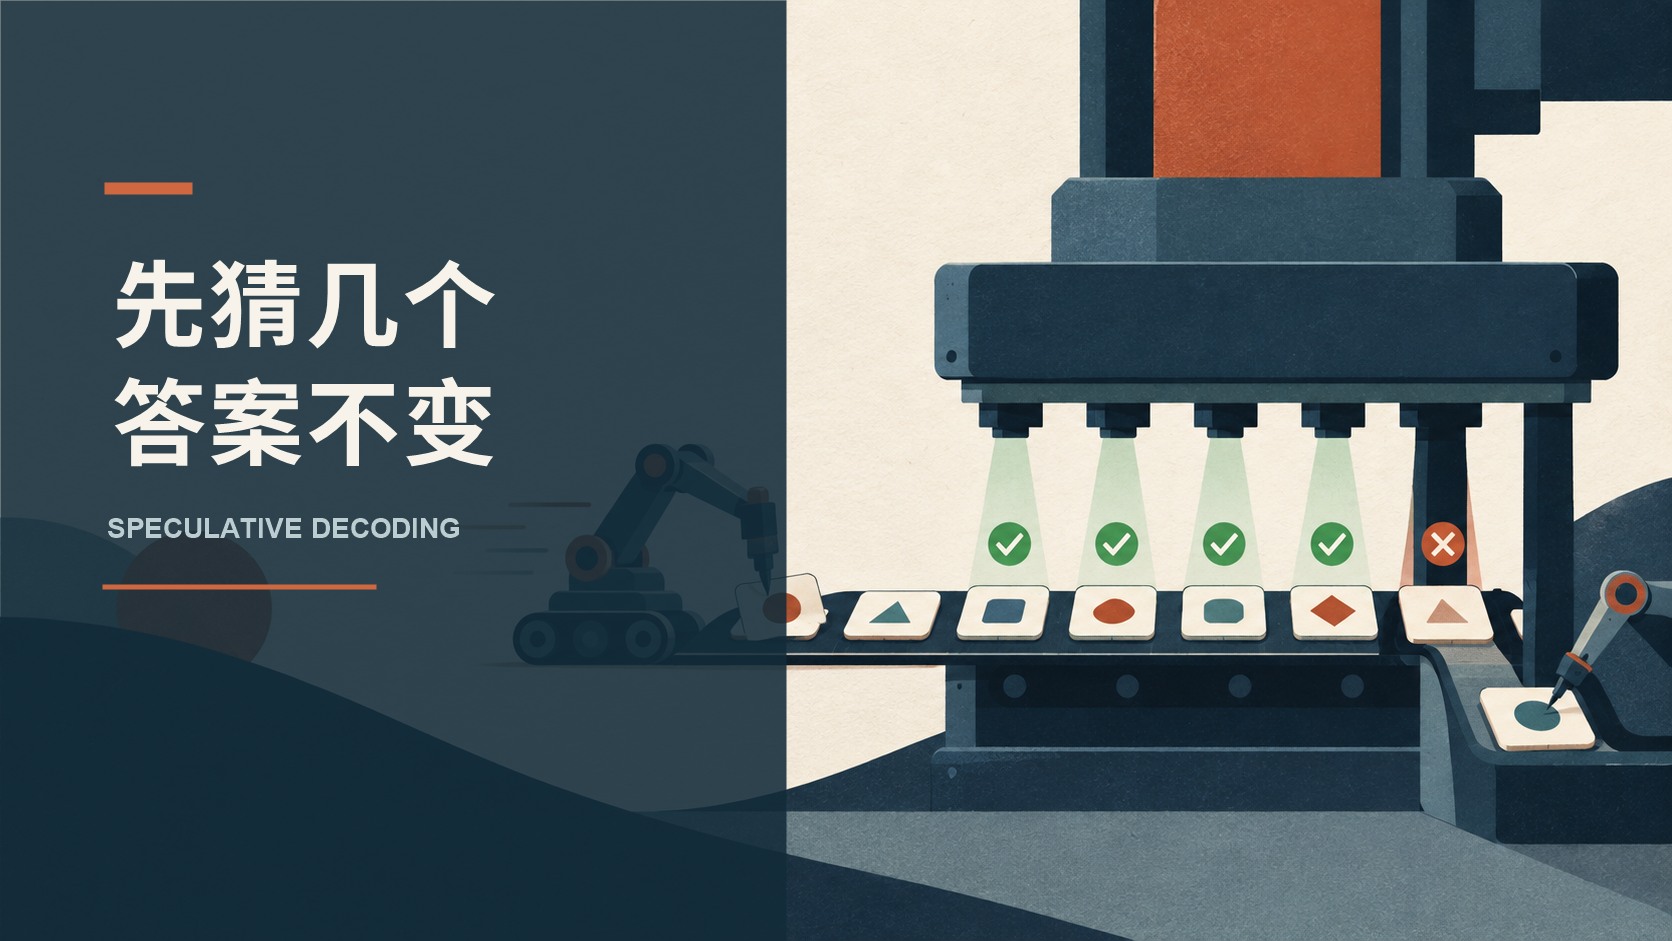
推测解码:先猜几个 token,为什么答案仍然没变
推测解码让小模型先起草多个 token,再由大模型一次并行验证。本文从串行瓶颈、拒绝采样校正和收益模型出发,解释它为什么能提速而不改变目标模型的输出分布。
PagedAttention:局部更慢,系统为何更快
PagedAttention 的注意力 kernel 本身并不一定更快,却让 vLLM 获得更高服务吞吐。本文从 KV cache 的动态增长出发,解释分页、块表、按需分配与写时复制如何把显存管理变成推理系统的核心能力。