2023 年 2 月的 LLaMA 论文有一个不太像“突破”的地方:它几乎没有宣称发明新的核心模块。网络仍是 decoder-only Transformer;RMSNorm、SwiGLU 和 RoPE 都来自已有工作。它真正改变的,是一组工程选择被组合之后产生的结果——7B 到 65B 的模型,用公开可获得的数据训练到 1.0T 或 1.4T token,在相对容易部署的尺寸上逼近甚至超过更大的模型。
这件事后来比单次榜单胜负更重要。一个性能足够强、结构足够标准、尺寸覆盖足够完整的模型族,让微调、量化、推理框架和下游工具终于可以围绕同一套“共同底座”协作。LLaMA 的历史意义,不是把 Transformer 推倒重来,而是证明:把成熟组件、训练预算和发布方式配得足够好,也能改变技术扩散的速度。
先把模型做得值得部署
LLaMA 直接承接了 Chinchilla 的问题意识,却把目标从“固定训练算力下的最低损失”向部署端移动了一步。论文指出,Chinchilla 式计算最优没有计入推理预算;如果模型要被调用很多次,更小的模型即使需要看更多 token,生命周期总成本也可能更低。
于是 LLaMA-7B 训练了 1T token,33B 和 65B 训练了 1.4T token。论文报告,13B 在多数基准上超过 175B 的 GPT-3,65B 则与 Chinchilla-70B、PaLM-540B 竞争。这里需要保留两个限定:这些是论文当时采用的学术基准,不等于今天的产品体验;“多数基准超过”也不等于所有能力都更强。但它足以支持一个关键判断:参数规模不再是获得可用能力的唯一通道。
更小的模型把研究门槛也一起压低。Meta 当时明确强调,13B 可以在单张 V100 上推理。训练仍然昂贵,但复现实验、做适配器微调、测试量化与安全方法,不必先拥有一座训练集群。LLaMA 把“能研究前沿模型”和“能从头训练前沿模型”分成了两件事。
一套没有原创神话的架构配方
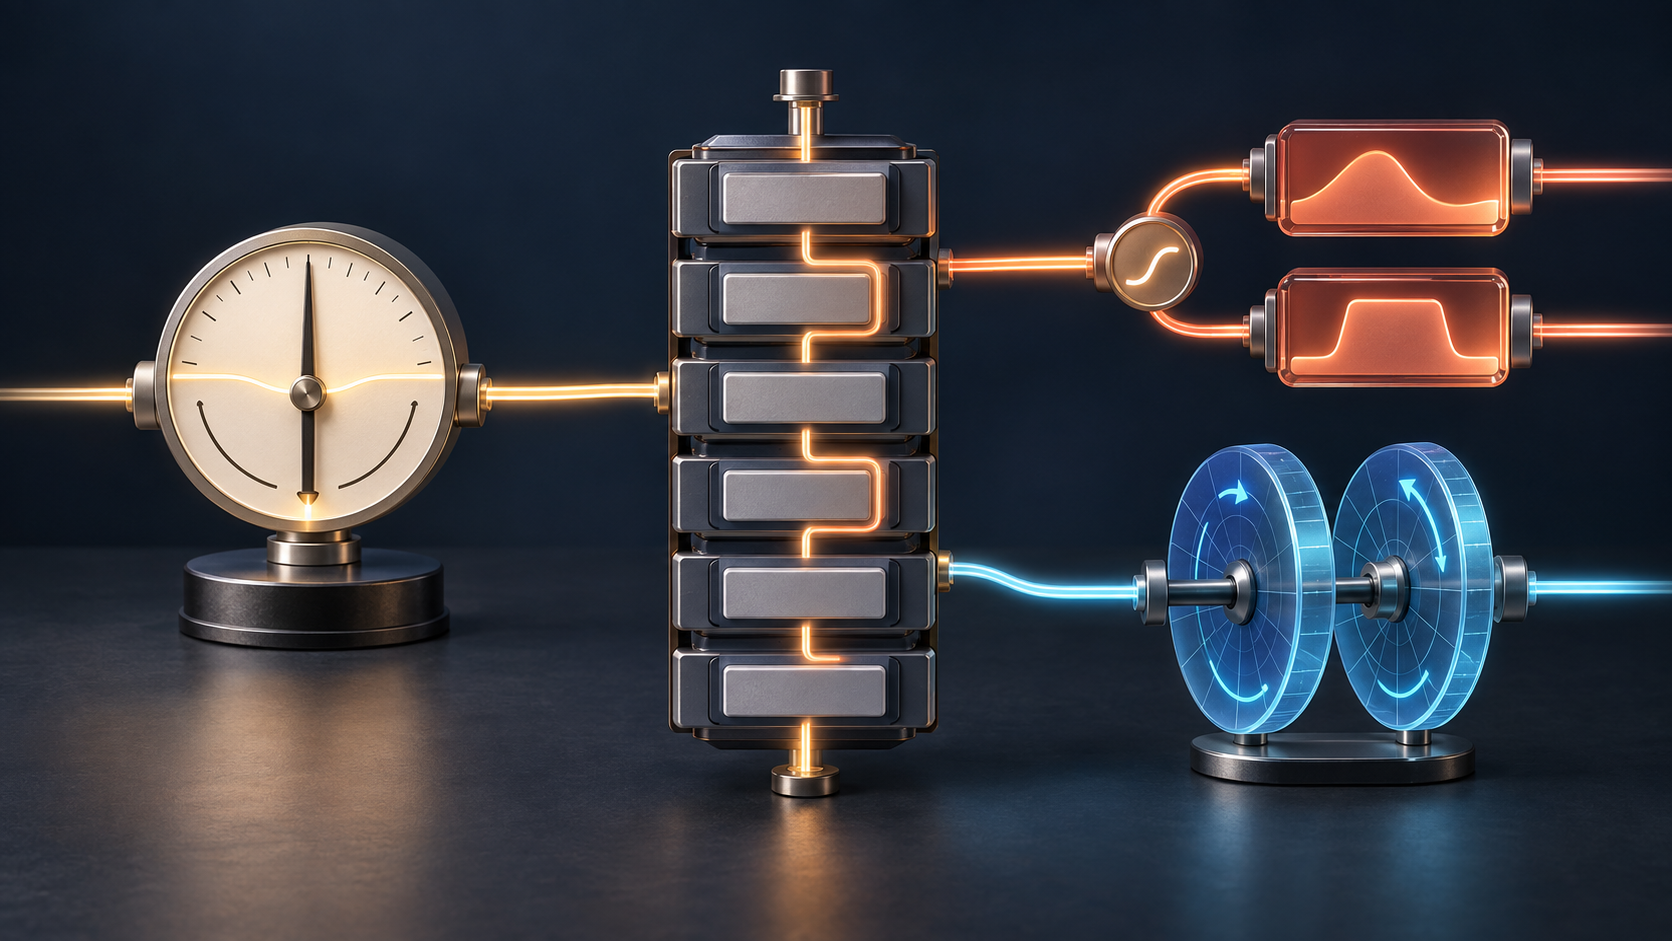
图 1:初代 LLaMA 把 RMSNorm、SwiGLU 与 RoPE 三种已有机制组合进标准 decoder-only Transformer
初代 LLaMA 的主干可以概括为三处替换。它们都不是论文首创,价值在于经过大规模训练验证后形成了一套简洁、稳定的默认配方。
第一处是 pre-normalization + RMSNorm。原始 Transformer 在残差相加后做 LayerNorm,LLaMA 则在每个子层进入注意力或前馈网络之前归一化。RMSNorm 只按均方根缩放,不减去均值:
$$\operatorname{RMSNorm}(x)=\frac{x}{\sqrt{\frac{1}{d}\sum_i x_i^2+\epsilon}}\odot g$$它的直接目的不是制造新能力,而是让深层网络的训练更稳定,并用更简单的统计量完成尺度控制。
第二处是 SwiGLU 前馈层。传统 ReLU 前馈网络只有一条激活路径;SwiGLU 用一条分支生成门,另一条承载内容,再逐元素相乘:
$$\operatorname{SwiGLU}(x)=\operatorname{SiLU}(xW_g)\odot(xW_v)$$门控让网络能按输入调节哪些特征通过。LLaMA 同时把前馈隐藏维度设为约 $\frac{2}{3}\times4d$,在门控带来的额外投影与总参数量之间做平衡。
第三处是 RoPE。它不把绝对位置向量加到 token embedding 上,而是在每一层对 query 和 key 的二维通道对施加随位置变化的旋转。若位置 $m,n$ 分别使用旋转矩阵 $R_m,R_n$,注意力内积满足:
$$ (R_m q)^\top(R_n k)=q^\top R_{n-m}k $$右侧只与相对位移 $n-m$ 有关。这是 RoPE 最漂亮的地方:绝对位置通过旋转进入向量,而 query-key 的匹配自然显出相对距离。它后来成为许多开放模型的默认选择,但“流行”不代表可以无限外推;超过训练长度时仍需要频率缩放、重新训练或其他长上下文策略。
GQA 不是初代 LLaMA 的发明
时间线常把 LLaMA、RoPE、GQA 写在同一格里,容易造成误解。LLaMA 1 使用标准多头注意力(MHA),没有 GQA。 GQA 在 Llama 2 中进入该模型族,而且只用于论文中的 34B 和 70B;Llama 2 的 7B、13B 仍用 MHA。到了 Llama 3,Meta 才把 GQA 同时用于 8B 与 70B。
GQA 解决的是自回归生成时的内存带宽问题。生成下一个 token 时,模型会缓存之前所有 token 的 key 和 value。其显存量可粗略写为:
$$M_{KV}\approx 2LSn_{kv}d_hb$$其中 $L$ 是层数,$S$ 是已生成长度,$n_{kv}$ 是 KV head 数,$d_h$ 是每个 head 的维度,$b$ 是每个元素的字节数。序列越长、并发越大,读取 KV cache 越容易成为瓶颈。
| 注意力形式 | Query heads | KV heads | 取舍 |
|---|---|---|---|
| MHA | 多个 | 与 Query 一样多 | 表达最充分,KV cache 最大 |
| MQA | 多个 | 1 个 | cache 最小,可能损失质量 |
| GQA | 多个 | 若干组 | 在质量与带宽之间折中 |
GQA 让一组 query head 共享同一组 key/value head。原始 GQA 论文报告,它能得到接近 MHA 的质量和接近 MQA 的速度。Llama 2 的大模型采用 8 个 KV 投影,正是因为 KV cache 在大模型与高并发服务中更容易成为瓶颈。这里的演进很能说明 Llama 系列的设计风格:不追求模块命名权,而是挑选已被验证、能改善系统总成本的组件。
从研究发布到生态标准
初代 LLaMA 的“开放”需要准确描述。2023 年 2 月,Meta 以非商业研究许可、逐案申请的方式提供权重,并发布推理代码;它不是任何人都可直接商用的宽松开源许可证。2023 年 7 月,Llama 2 才把预训练与聊天模型以自定义社区许可证开放给研究和商业使用,同时提供权重与起始代码。
因此,更严谨的说法是 开放权重生态,而不是把它与传统软件开源完全等同。权重可获得,让社区能检查行为、微调模型、改变推理实现;但训练数据没有完整发布,许可证也包含使用限制,社区无法仅凭权重重现整个训练过程。
即便如此,生态扩张非常快。Meta 在 2023 年 9 月披露,Llama 系模型在 Hugging Face 上累计下载超过 3000 万次,已有 7000 多个衍生模型、7000 多个构建或提及 Llama 的 GitHub 项目。云平台、芯片厂商、量化工具和本地推理框架开始把 Llama 兼容性当作基础能力。
这些数字的意义不只在“受欢迎”。当模型的层结构、张量命名、tokenizer 与权重格式成为事实接口,新的量化方法只需先支持一套主流模型,推理引擎也能围绕同一组尺寸优化内核。生态反过来降低模型的部署成本,又吸引更多微调与工具加入,形成正反馈。LLaMA 最强的护城河不只是某个 benchmark 分数,而是大量工具默认先问一句:能不能兼容 Llama?
这套成功也有边界
“公开可获得的数据”不等于数据没有争议,也不等于训练可完整复现。LLaMA 论文公开了数据来源和混合比例,其中 CommonCrawl 占 67%,还包括 C4、GitHub、Wikipedia、Books、arXiv 与 Stack Exchange;但社区并没有得到经过清洗后的精确训练集。数据去重、过滤和版本差异足以显著改变模型。
语言覆盖也不均衡。初代论文选择了使用人数最多的 20 种语言,但重点是拉丁和西里尔字母;Llama 2 论文进一步承认其预训练数据以英语为主,非英语性能脆弱。对中文场景而言,“开放权重”降低了适配门槛,却没有自动消除语料与评测缺口。
最后,权重开放把一部分责任从模型提供方移到部署者。Llama 2 同时发布了聊天微调、安全评估和使用指南,但论文也明确说测试不可能覆盖所有场景。一个基础模型可以被改造成医疗问答、代码助手或离线代理;这些系统拥有不同的风险面,不能继承一张通用安全成绩单。开放让审计与改进更容易,也让能力复制与误用更容易——两面都是真的。
真正留下来的设计原则
回看 LLaMA,最值得学习的不是把 RMSNorm、SwiGLU、RoPE 和 GQA 再抄一遍,而是它背后的三层取舍。
第一,模型设计应同时优化训练与长期推理,而不是只追求一次训练的算力最优。第二,架构创新不必每层都新;把成熟组件组成稳定、可实现、可部署的系统,本身就是重要贡献。第三,发布策略会改变技术价值:相同权重如果没有可用代码、许可证和工具支持,只是一份研究结果;一旦形成共同接口,就可能变成平台。
所以 LLaMA 的核心故事并不是“小模型打败大模型”的又一次反转。它展示的是另一种规模效应:模型本身可以更紧凑,但围绕它形成的协作网络可以非常大。真正被放大的,不只是参数,而是复用。
参考资料
- Touvron et al., LLaMA: Open and Efficient Foundation Language Models, 2023.
- Meta AI, Introducing LLaMA: A foundational, 65-billion-parameter large language model, 2023.
- Touvron et al., Llama 2: Open Foundation and Fine-Tuned Chat Models, 2023.
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, 2023.
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021.
- Meta AI, The Llama Ecosystem: Past, Present, and Future, 2023.
- Meta AI, Introducing Meta Llama 3, 2024.